Jetzt zum Webinar anmelden

November 2026 · Unser Geburtstagsgeschenk
35 Jahre iBusiness.
Im November alles frei lesen.
Zum Jubiläum öffnen wir alle iBusiness-Inhalte: vom 1. bis 30. November, für alle, ohne Anmeldung und ohne Bezahlschranke.
Alle Inhalte im November kostenlosRegistrieren Sie sich kostenlos und abonnieren Sie anschließend den iBusiness-Newsletter. So bleiben Sie bei den Themen auf dem Laufenden, die für Sie zählen.

Datenstrategie: Wie Unternehmen Data Lakes optimal nutzen
18.11.2020 Data Lakes treiben aktiv die Digitalisierung voran. Doch es reicht längst nicht aus, Data Lakes mit allen möglichen Daten zu fluten. Vielmehr geht es darum, die Chancen dieses Konzeptes richtig zu nutzen.

HANDLUNGSRELEVANZ
|
|
Operativ |
Strategisch |
Visionär |
|
Technik |

|
|

|
|
Medien |

|
|
|
|
Wirtschaft |
|
|
|
|
|
heute |
morgen |
übermorgen |
Dahinter steckt der Gedanke, dass bei der Entkopplung von Speicherung und Analyse eine unabhängige Skalierung beider Prozesse möglich ist. Zudem setzen Data Lakes den bisweilen zahlreichen Datensilos, in denen sich viele Unternehmen verzetteln, ein Ende. In solchen Silos werden abteilungs- oder bereichsweise die unterschiedlichsten Datenspeicher voneinander isoliert betrieben.
Dies geschieht häufig aufgrund eines sehr starren Bereichsdünkels rund um das Besitztum von Daten und deren Erkenntnishoheiten. Darüber hinaus sind mit Data Lakes nicht zuletzt wegen der Vielzahl an bereitgestellten Informationen aussagekräftigere und tiefergehende Analysen bereitzustellen. Auf diese Weise können sich für Unternehmen vielversprechende Wettbewerbsvorteile ergeben.
Im Vergleich dazu sind die starr strukturierten Datenbankformate wie beispielsweise herkömmliche Data Warehouses dementsprechend unflexibel. Beim Data Warehousing gehen natürlich alle unstrukturierten Daten wie E-Mails, Word-Files oder Daten aus Systemen, die nicht ans Data Warehouse angebunden sind, in ihrer Quellstruktur verloren (siehe iBusiness: Smartes Wissensmanagement - So schöpfen Sie aus Data Lakes).
Problemzonen rechtzeitig erkennen
Mit der Implementierung von Data Lakes lauern auch zahlreiche Fallen. Manche Unternehmen neigen dazu, mit Data Lakes riesige "Datenfriedhöfe" anzulegen. In der Folge sind sie dann nicht imstande, die abgelegten Daten sinnvoll auszuwerten. Nur Unternehmen, die auch über die entsprechenden Spezialisten verfügen und fortwährend neue Abfragen und Anwendungen auf Basis des Data Lakes erstellen, können die gewünschte Flexibilität tatsächlich voll ausschöpfen.Die Daten könnten zwar mit großen Volumina verarbeitet werden, aber oft bereitet es den Unternehmen Schwierigkeiten, die Relevanz, Vollständigkeit, Integrität und Qualität der Daten zu gewährleisten. Nicht selten kommen absolut widersprüchliche Konzepte wie zum Beispiel eine Blockchain zum Einsatz, die ein hoch standardisiertes Datenformat verlangt und daher quasi das Gegenteil eines Data Lakes darstellt.
Strukturierte Daten zulassen
Eine weitere Herausforderung ist der Datenschutz. Es gibt diverse Regularien wie zum Beispiel die Datenschutz-Grundverordnung (DSGVO), die verhindern, dass alle möglichen Daten einfach im Data Lake gespeichert werden dürfen. Zudem können der Kontext sowie die Semantik von Daten beim Ablegen in den Data Lake verloren gehen.So ist es oftmals wesentlich zu wissen, welches Datum der Information zugeordnet werden kann. Das bedeutet, dass innerhalb des Data Lakes tatsächlich auch ein Minimum an Struktur vorherrscht. Dies ist nicht so einfach in den Griff zu bekommen, denn ein Eintrag mit einem Datum kann wiederum Rohdaten enthalten, die nicht unbedingt diesem Datum zuzuordnen sind. Auf diese Weise wird aus einem "Data Lake" schnell ein "Data Swamp", ein Datensumpf, der sich nur noch schwer auswerten lässt.
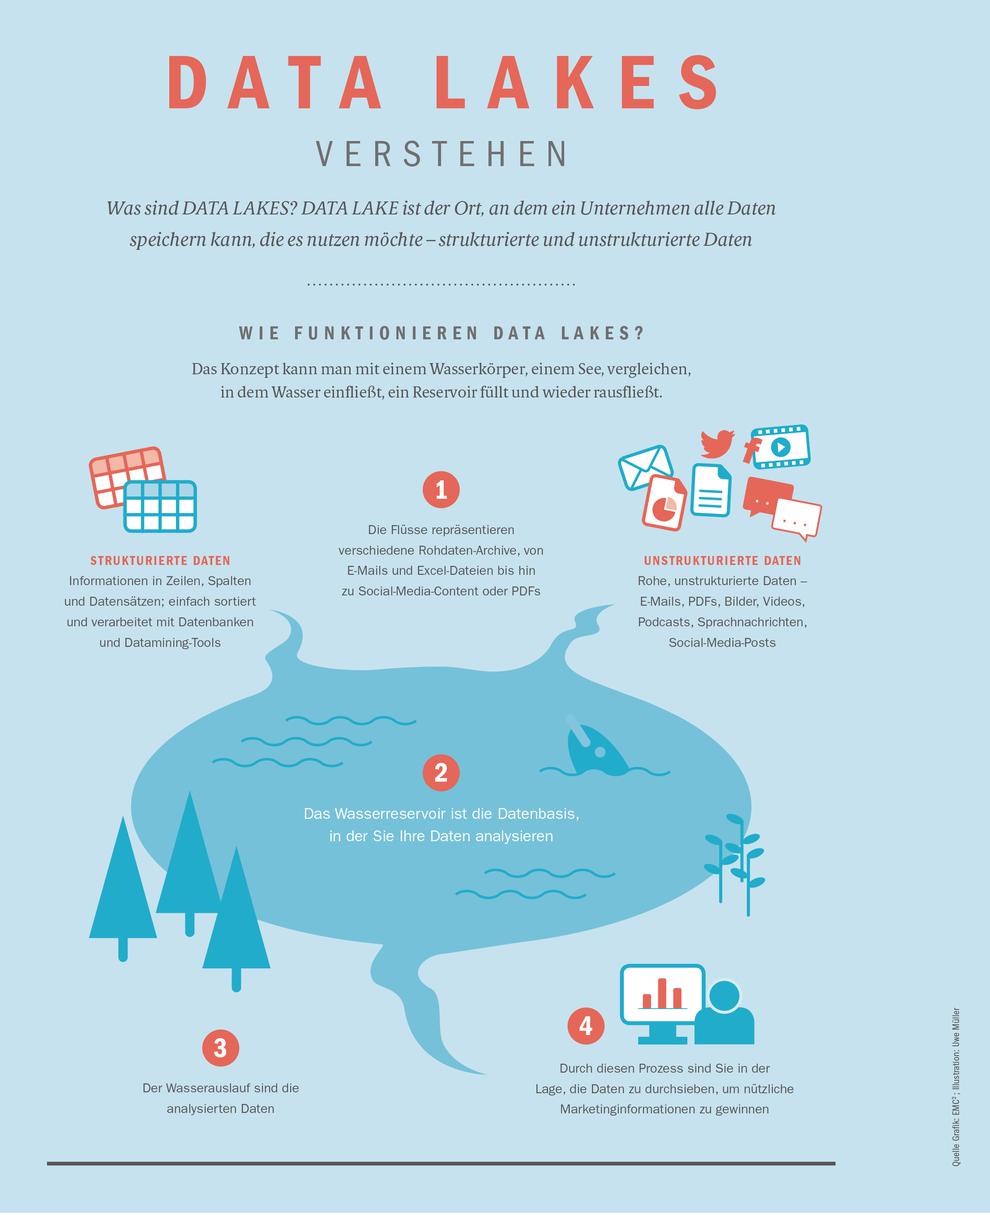
Andererseits können so auch strukturierte Daten in einen Data Lake abgelegt und gleichsam wichtige Analysen aus nicht vollständigen Daten getätigt werden. Das heißt, es besteht beispielsweise die Möglichkeit, die Metadaten von verschlüsselten Daten auszuwerten, für den Fall, dass sie mit vorgehalten sind.
Somit ist ein Data Lake kaum ein Ersatz für herkömmliche IT-Strukturen oder ein Data Warehouse, sondern eine sinnvolle Ergänzung, falls im Unternehmen häufig große Mengen unstrukturierter Daten entstehen, die dafür genutzt werden, neue Geschäftsideen voranzutreiben.
Bereitstellung und Realisierung
Die Implementierung eines Data Lakes erfordert nicht nur Zeit, sondern auch erfahrene Experten. Für den Projektstart sind vorab Zielsetzungen als auch Regeln für die unternehmensweite Nutzung abzuklären. Nicht selten verharren Unternehmen in langwierigen internen Diskussionen über optimale Designs, mögliche Produkte und geeignete Anbieter. Die Bereitstellung fortschrittlicher Analyseprogramme, die beispielsweise den digitalen Vertrieb und das Marketing sowie die Entwicklung neuer Produkte unterstützen, wird gerne vernachlässigt.Stattdessen sollten Unternehmen einen agilen Ansatz für das Design und die Einführung von Data Lakes verfolgen, indem sie eine Reihe von Technologien und Managementansätzen testen, um so die Prozesse für die Datenspeicherung sowie deren Zugriffe zu optimieren.
Projektentwicklung von Data Lakes
Bei der Entwicklung und Integration von Data Lakes durchlaufen Unternehmen im Allgemeinen vier Entwicklungsstufen: die Rohdatenphase, Experimentierphase, Entlastung der Data Warehouses und Ersatz anderer Datenspeicher.Rohdatenphase
Für den ersten Schritt wird der Data Lake isoliert von den wesentlichen IT-Systemen erstellt und dient zunächst als eine kostengünstige, skalierbare "Pure Capture"-Umgebung zur reinen Datenerfassung. Der Data Lake soll in dieser Phase als reine Datenverwaltungsebene innerhalb des Technologie-Stacks eines Unternehmens dienen. Die Rohdaten werden eingespeist, bevor sie für die Verwendung in den jeweiligen Computerumgebungen vorbereitet werden. In dieser frühen Projektphase ist eine strenge Governance erforderlich. Nicht zuletzt, um einen Datensumpf zu vermeiden.
Experimentierphase
In dieser nächsten Phase soll der Data Lake als aktive Plattform für Tests genutzt werden. Data Scientists erhalten durch den einfachen und schnellen Zugriff auf Daten die Möglichkeit, erste Analysen mit den erfassten Daten durchzuführen. In einer solchen isolierten Umgebung (Sandbox) können nun verschiedene Software-Lösungen mit unveränderten Daten getestet werden, um schließlich Prototypen für spätere Analyseprogramme zu erstellen. Dazu eignen sich eine Reihe von Open-Source- sowie kommerzielle Tools, um die einzelnen Prüfstände zu errichten.
Entlastung der Data Warehouses
Auf dieser Ebene werden "kalte" Daten, die eher selten oder fast nie Verwendung finden, aus den Data Warehouses zunehmend in Data Lakes gespeichert. Damit profitieren Unternehmen unter anderem von den geringeren Speicherkosten der Data Lakes. Gleichzeitig können Unternehmen relationale Daten in den Data Warehouses, die für die Verarbeitung dieser Daten zuständig sind, weiterhin mit hoher Intensität extrahieren. Auf diese Weise lassen sich Extraktions- und Transformationsaufgaben in den Data Lake migrieren. Beispielsweise eine Suche vom Typ "Nadel im Heuhaufen", bei der Data Scientists Datenbanken nach Abfragen durchsuchen, die von herkömmlichen Indexstrukturen nicht unterstützt werden.
Ersatz anderer Datenspeicher
In diese Phase des Rollouts wird bereits ein Großteil der Daten, die durch das Unternehmen fließen, in einen Data Lake übertragen. Somit wird der Data Lake zu einem zentralen Bestandteil der Dateninfrastruktur eines Unternehmens. Er ersetzt vorhandene Data Marts oder betriebliche Datenspeicher und ermöglicht die Bereitstellung von Daten als Service.
Damit sind Unternehmen in der Lage, rechenintensive Aufgaben beispielsweise für die Durchführung von Industrial Analytics oder die Bereitstellung von Programmen für Maschinelles Lernen zu bewältigen. Manche Unternehmen entscheiden sich dafür, datenintensive Anwendungen oder ein Dashboard für das Leistungsmanagement auf dem Data Lake zu erstellen. Oder sie implementieren APIs, um Informationen aus Data-Lake-Ressourcen nahtlos mit Informationen aus anderen Anwendungen zu kombinieren.
Bereit für das Unerwartete
Data Lakes, Big Data und Industrial Analytics können Unternehmen maßgeblich verändern. Die Herausforderungen liegen vor allem in der technischen Umsetzung und Aufbereitung der Daten. In den heutigen extrem dynamischen Geschäftsumgebungen sind die Anforderungen an dem Umgang mit Daten als auch deren Anwendungsfälle einem rapiden Wandel unterworfen.Die gesamte Philosophie eines Data Lakes dreht sich im Prinzip darum, für einen bis dato unbekannten Anwendungsfall bereit zu sein. Das heißt, wenn die Quelldaten in einem zentralen Speicher bereitgestellt werden, in dem keine oder nur wenige Kontrollstrukturen eingebettet wurden, kann sich die Unterstützung für einen neuen Anwendungsfall deutlich einfacher und effektiver gestalten.
Kommentar von Dominik Grollmann
Vom See zur Kloake
Data Lake - klingt trivial: Einfach alles reinkippen, was man hat. Doch wer so handelt, watet schnell im Sumpf.
Weiterlesen