


Jetzt zum Webinar anmelden

November 2026 · Unser Geburtstagsgeschenk
35 Jahre iBusiness.
Im November alles frei lesen.
Zum Jubiläum öffnen wir alle iBusiness-Inhalte: vom 1. bis 30. November, für alle, ohne Anmeldung und ohne Bezahlschranke.
Alle Inhalte im November kostenlosRegistrieren Sie sich kostenlos und abonnieren Sie anschließend den iBusiness-Newsletter. So bleiben Sie bei den Themen auf dem Laufenden, die für Sie zählen.

Big Data: Wie Unternehmen aus Daten künftig Wissen extrahieren
09.02.2012 Es ist wie Gold waschen. Doch wenn die Flusspegel steigen, gibt es nicht nur mehr Gold, sondern zunächst einmal mehr Wasser. Sechs Methoden, wie Unternehmen mit Business Intelligence und zukunftssicheren Analytics-Methoden verhindern, dass das steigende Datenaufkommen das Getriebe der Unternehmen lahmlegt.
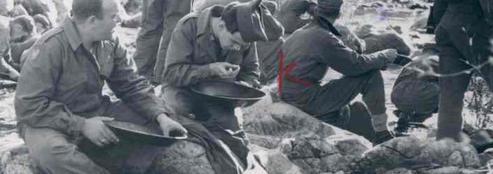


Erst langsam lernt die Wirtschaft, wie große Datenmengen richtig verarbeitet werden und welch großer Wert in ihnen liegt. Hieß es früher "lösch sie doch einfach", ist heute ein solcher Umgang mit Dateien undenkbar. Ein Sinneswandel hat sich vollzogen: Daten sind nun nicht nur eine Last, die Speicher benötigen. Sondern in ihnen versteckt sich viel Gold. Man muss es nur herauswaschen. Man muss für sie Verständnis entwickeln. Nicht umsonst sprechen Experten von 'Data Mining' im Umfeld künftiger Business-Intelligence-Lösungen.
Keine Frage, die nackten Zahlen klingen zunächst schwindelerregend und wirken erschlagend. So ist davon die Rede, dass sich die Menge an Geschäftsdaten alle 1,2 Jahre verdoppelt. Und die Quellen dieser riesigen Datenmengen stammen aus den unterschiedlichsten Bereichen. Zum Beispiel der Sendungsverfolgung, E-Mail, Web-Datenverkehr und Social Media, wie eine Studie des McKinsey Global Institute belegt.
"Es ist zu erwarten, dass das Datenvolumen in den nächsten zehn Jahren um das Zehnfache wächst und in 2020 die magische Grenze von 35 Zettabytes erreicht ist", sagt Tom Cahill , Vice President EMEA bei Jaspersoft .
Von diesen Daten sind etwa 80 Prozent unstrukturiert, so Cahill - dies erschwere das Herausfiltern wertvoller Informationen deutlich. "Der Einsatz von Business-Intelligence-Lösungen mit leistungsstarken Analysefunktionen kann Unternehmen hier einen entscheidenden Wettbewerbsvorteil verschaffen", sagt Cahill. Denn Big Data bezeichnet gerade die Fähigkeit, die verschiedenen Parameter von Daten in einem Business-Intelligence-System zu vereinen.
Bei Big Data kommen nach Einschätzung von Holger Kisker Analyst von Forrester Research , verschiedene Parameter zusammen, die die Datenlage komplex machen und zu den vier Vs führen:
- Volumen - große Datenmengen, üblicherweise jenseits 1 Petabyte (1000 TByte, eine Million GByte),
- Velocity - die Geschwindigkeit, was nicht immer Echtzeit bedeuten muss,
- Variety, die Vielfalt von Datenformaten, z.B. strukturelle, semistrukturelle und unstrukturierte Daten,
- Variability oder Flexibilität der Interpretation, es gibt nicht nur eine Version der Wahrheit.
Auch wenn Big Data damit zum Schnittpunkt verschiedener Parameter wird, bleibt für die meisten Unternehmen, die sich mit Big Data befassen, das "Datenvolumen die treibende Kraft", weiß der Marktforscher, der zugleich darauf hinweist, dass der gesamte Business-Intelligence-Markt in 2012 ein Volumen von rund 23,5 Milliarden US-Dollar erreichen wird.
Die Wertschätzung von Daten hat sich gewandelt
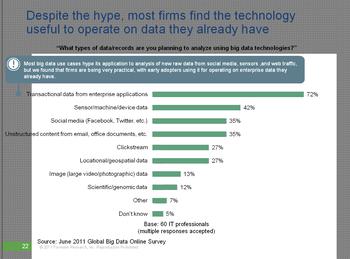
"Wir befinden uns in dem Schritt, dass unsere Fähigkeit, riesige Datenmengen in Businesswert umzusetzen, auch zunimmt", sagt Holger Kisker. Somit sei das Problem gar nicht so groß, "man kann diese riesigen Datenmengen gewinnbringend nutzbar machen".Kisker weist zudem auf folgende Erkenntnis hin: Obwohl es sich beim aktuellen Big-Data-Hype meist um Social Media dreht, benutzen die meisten Firmen Big-Data-Ansätze zurzeit "eher für interne, transaktionale Daten (72 Prozent) und 'nur' 35 Prozent für externe Social-Media-Daten". Big Data ist dabei das Phänomen, das für Report-Automation stehende Business Intelligence ist dabei die Methode.
"Das ganze Verständnis der Firmenprozesse - das Qualitätsmanagement von Daten muss neu überdacht werden", so Kisker. Es gehe um den Rahmen der Governance-Prozesse, der die Informationsqualität, die Sicherheit, die Standardisierung oder das Lifecycle-Management regelt. Auch der Gesetzgeber sei gefragt, denn auch die rechtlichen Rahmenbedingungen hinken, gerade im Bereich von Social Media und persönlichem Datenschutz, hinterher. Einfach nur ein Analysetool zu haben führe nicht zum Erfolg, "wir brauchen eine Neudefinition", fordert Kisker.
| Fünf Herausforderungen beim Management von Big Data |
|---|
|
Im Folgenden verdeutlichen sechs Essentials, wie groß das Potenzial von Big Data künftig sein wird:
1. Hohe Qualität und Architekturprinzipien als Basis
"Man braucht eine hohe Datenqualität, um zu guten Ergebnissen zu kommen", sagt Theo Ruland , Geschäftsführer der Sybase GmbH So kümmere sich heute ein Chief Data Officer um die Qualität und Anzahl der Daten, und darum, etwa Dubletten zu filtern. "Daten werden als Asset des Unternehmens angesehen", sagt Ruland, der das hohe Aufkommen von Daten als eine Chance ansieht, weil er weiß, dass die Industrie sehr schnell darauf reagieren kann. Das zeigen nicht zuletzt die gefallenen Preise für hohe Datenspeicher.Um die wachsende Summe der Daten auswerten zu können, sind "gewisse Architekturprinzipien" notwendig, wie der Sybase-Chef es beschreibt. Er unterscheidet zwei Ansätze, um Analysedaten zu speichern:
- Column-Store oder spaltenorientierter Ansatz: Daten werden in Spaltenform gespeichert und erreichen so einen hohen Komprimierungsgrad, wodurch der Speicherplatzbedarf deutlich geringer wird. Dieser Ansatz verkürzt auch die Reaktionszeit bei Datenabfragen - sie können viel schneller ausgelesen werden als bei den konventionellen Verfahren. Zudem werden die Daten beim Laden in die Datenbank automatisch indexiert.
- In-Memory-Ansatz: Daten werden im RAM gespeichert. Dieser Ansatz ist zwar in 32-Bit-Umgebungen unbestritten schnell, aber aufgrund der relativ geringen Speicherkapazität nicht effektiv. Hingegen kann der Ansatz in 64-Bit-Systemen mit ihrem inhärent größeren RAM sinnvoll sein, kostet aber mehr.
"Beim Column-Store-Ansatz kommt es zu Komprimierungsdaten von 40 bis 90 Prozent im Vergleich zu konventionellen zeilenbasierten Systemen", unterstreicht Theo Ruland, der von "intelligenten Analysewerkzeugen" spricht, die Datenströme schon zum Zeitpunkt ihres Entstehens analysieren können. Auf diese Weise können nach Ansicht von Ruland etwa in der Finanzwelt "Marktentwicklungen und Risikoanalysen viel genauer und effizienter getroffen werden."
2. Maschinen und Menschen als Treiber der Datenmengen
"Big Data ist in aller Munde", sagt Wilfried Hoge von IBM . Er stuft die sich daraus ergebende Chance, neue Quellen an Daten auszuwerten, als "gewaltig" ein. Das Problem bestehe darin, die Daten auch nutzbar zu machen, meint Hoge.Während es sich bisher eher um strukturierte Daten handelte, z.B. Tabellen, handle es sich jetzt um eine Welt vielfältig strukturierter Daten, die von Textinformationen oder XML-Formaten bis hin zu GPS Daten oder Video- und Audiodateien reicht.
Als Treiber der gewachsenen Datenmengen sieht Hoge zum einen die Maschinen wie etwa Smart Meter oder Bewegungsmelder und zum anderen die Menschen und den weiter expandierenden Bereich des Social Media. Es sind Informationen, die in einer "riesigen Menge" vorliegen und bei denen sich die Frage aufdrängt, wie man am besten damit umgeht, sagt der IBM-Mann.
Ozean und Fluss von Daten sind in einer Plattform vereint
Eine weitere Dimension des Big-Data-Spektrums ist die Verarbeitungsgeschwindigkeit. In diesem Zusammenhang kommt schnell der Begriff der Echtzeitverarbeitung ins Spiel. "Volumen, Variabilität und Verarbeitung, man kriegt nicht alles auf einmal", so Hoge, der weiß, dass verschiedene Technologien notwendig sind, um Real-time Analytic Processing zu gewährleisten. Hoge spricht vom "Ozean und Fluss von Daten, die in einer Plattform vereint sind."
IBM hat nach Angaben von Wilfried Hoge in diesem Umfeld eine Technologie entwickelt, die eine Plattform zur Adressierung von Volume, Variety und Analytic darstellt. Dabei ist die Frage entscheidend, was mit den Daten passiert und wie sie im Unterschied zum Data Warehouse analysiert werden.
Algorithmen machen den entscheidenden Unterschied
Während bisher die Analysen nach einem festen bestehenden Schema erfolgten und dadurch zuvor eine Transformation der Daten notwendig wurde, entsteht in der Big-Data-Welt das Schema erst im Nachhinein. "Daher sind die Algorithmen besonders wichtig, die erst Daten erkennen und sogleich Analysen ermöglichen", bestätigt Hoge. So werde etwa der Unterschied schnell klar erkennbar, wenn es sich beispielsweise um Videodaten handelt.
Für Dr. Ingo Mierswa , Geschäftsführer von Rapid-I , ist es die Suche nach bislang unbekannten Zusammenhängen, die eine "frühzeitige Erkennung neuer Geschäftsmöglichkeiten erlaubt und damit echten Business Value schafft". Moderne Analysetools wie RapidMiner in Kombination mit einer verteilten Datenhaltung, wie etwa Apache Hadoop sie biete, könnten diese Einblicke oftmals in Echtzeit liefern und "erlauben somit insbesondere eine enge Verzahnung mit operativen Geschäftsprozessen", sagt Mierswa. Beispiele für einen solchen Nutzen seien die "frühzeitige Detektion von Kunden mit Abwanderungstendenzen oder Vertriebsoptimierungen durch Kombination der CRM-Daten mit Social-Media-Analysen."
Apache Hadoop, ein freies, in Java geschriebenes Framework für datenintensive, verteilt arbeitende Anwendungen, erlaubt Anwendungen intensive Rechenprozesse im Petabyte-Bereich mit Tausenden von Knoten. In den vergangenen Wochen und Monaten haben unter anderem EMC , Microsoft, IBM, Oracle , Informatica , HP , Dell und Cloudera das Framework übernommen.
3. Der Trend geht in Richtung Echtzeitanalyse
Bei den heutigen Datenmengen sei eine Transformation der Daten nicht mehr möglich, unterstreicht Wilfried Hoge. Verfahren seien notwendig, die, sobald die Daten vorliegen, "ohne Anpassungsaufwand verarbeitet werden können".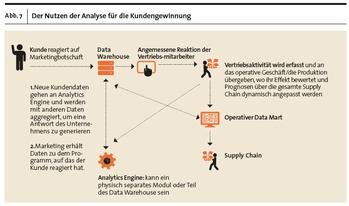
Der Trend geht in Richtung Echtzeit, etwa in der Medizin. So werden beispielsweise in der Klinik von Toronto Frühgeburten überwacht, indem Millionen von Datensätzen permanent kontrolliert und ausgewertet werden, wenn Anomalien vorliegen. "Echtzeitanwendung und Echtzeitanalyse, sodass auch direkt Entscheidungen getroffen werden können", betont Hoge, der im nächsten Atemzug den Bereich der Verkehrssplanung erwähnt: Anhand von Handybewegungen innerhalb der Stadt, sodass man die Verkehrsflüsse analysieren kann. Auch hier geht es um "Entscheidungen, die man zeitnah treffen muss".
Mit zeitnahen Entscheidungen neue Kundengruppen erschließen
Gerade im Bereich Entscheidungsfindung sei hier die "Unterstützung durch Reporting- und Analysewerkzeuge, die den Anwendern einen hohen Grad an Interaktion mit den Daten gestatten", gefragt, bestätigt auch Tom Cahill. Für Entscheider seien im Tagesgeschäft besonders Dashboards, die die wichtigsten Daten grafisch gut aufbereitet zusammenfassen, eine "große Unterstützung". Seien erst einmal die durch Social-Media-Promotions gewonnenen Daten gesichtet und in das ERP- und CRM-System eingepflegt, "lassen sich für Unternehmen völlig neue Kundengruppen erschließen."
Im Vergleich zu früher ein großer Fortschritt. Denn galten doch Daten vormals als "eine Art Herrschaftswissen", ein Bereich, "in dem die Businessabteilung um die Reportings der IT-Abteilung gebettelt hat", erinnert Theo Ruland. Heute könne jeder Sachbearbeiter und jeder Kunde auf Daten zugreifen. "Daten sind demokratisiert und transparent geworden." Das bedeutet zugleich, "dass Entscheidungen fundierter sind, weil die Datenmenge größer ist." Sie stehen sogar in Echtzeit zur Verfügung. Das Warten auf den Bericht der IT entfällt. Für Ruland ist klar: "Wir stehen erst am Anfang solcher Analysen - es ist eine Art Gamechanging."
Flexibles Auswerten ist wichtig für die Echtzeitanalyse
Wenn es um Echtzeit geht, treten die Tracking-Spezialisten auf den Plan. Die Daten müssen, besonders bei Customer-Journey-Analysen, die die Bewegungsketten Offsite (Adviews) aufnehmen und besuchsübergreifend bis zur Onsite-Zielerfüllung verfolgen, "besonders flexibel auswertbar sein und die Systeme in der Lage, die entstehenden Datenmengen zu bewältigen", sagt Christian Sauer , Geschäftsführer bei Webtrekk . Ziel sei es, die Daten "jederzeit in alle gewünschten Richtungen zu analysieren." Darüber hinaus müssten die Bewegungsdaten einfach mit anderen Daten angereichert werden können, "um gezielter relevante von irrelevanten Ketten unterscheiden zu können".
Für den Webtrekk-Chef setzt die große Menge an Daten bei der Bewegungsanalyse und notwendige Flexibilität in der Auswertung und Datenanreicherung "ganz neue Maßstäbe an das Thema Echtzeitanalyse".
4. Das Interesse an Big Data ist groß, doch eine Durchdringung ist nicht in Sicht
Man sieht, dass das Interesse an Big-Data-Technologien groß ist, aber "noch ist keine breite Durchdringung erfolgt", stellt Wilfried Hoge klar. Gestartet sei es in "extrem modernen Unternehmen wie Twitter", deren Kernbestandteil die Daten sind.
Betrachte man Branchen, bei denen Daten nicht das Kerngeschäft sind, wo es nicht primärer Inhalt ist - "dort ist Big Data jetzt angekommen. Hier setzt es nun neue Möglichkeiten in Gang", weiß Hoge. Es sei im Moment noch die Zeit für innovative Unternehmen, sie können einen Wettbewerbsvorteil damit erzielen, dass sie in diesem Bereich tätig werden, "denn es gibt bisher keine Durchdringung", prognostiziert Hoge.
5. Cloud-Lösungen sind ideal für den Einstieg in Big Data
Um die Technologie und die Komplexität von Big Data in Form eines schnellen Starts kennen zu lernen ist die Cloud ideal, glaubt Hoge, denn dann müsse man sich nicht mit "hochkritischen Unternehmensdaten" auseinandersetzen.Eine cloudbasierte Business Intelligence kommt kleinen und mittleren Unternehmen entgegen, die sich keine eigene Analyse-Infrastruktur leisten können oder wollen. Cloud-Lösungen verschaffen ihnen wertvolle Einblicke in ihr Geschäft und ihre
Märkte, beschreibt auch der Analytics Guide "Intelligenz für jedermann", das die Sybase GmbH herausgegeben hat. Für die meisten großen Unternehmen seien die derzeit erhältlichen Analytics-Optionen in der Cloud jedoch "keine empfehlenswerte strategische Lösung", resümiert der Guide.
"Für den Einstieg in die Verarbeitung großer Datenmengen sind Cloud-Lösungen nicht mehr wegzudenken", ist Christian Sauer überzeugt. Betrachtet man den wachsenden Speicherhunger moderner Analyseverfahren wie z. B. der Customer-Journey-Analyse, so könne dieser "ohne eine flexible und skalierbare Datenverarbeitungsstruktur kaum mehr bewältigt werden", glaubt Sauer. Eine Cloud-Lösung ermögliche es, eine Vielzahl an Daten in ihrer Gesamtheit zu betrachten, ohne auf Informationen verzichten zu müssen. "Die Daten können in der Cloud erfasst und direkt verarbeitet werden", sagt Sauer. Ein "performanter und sicherer Zugriff" lasse sich dabei weltweit gestalten. Ein Fragezeichen steht bei Cloud-Lösungen derzeit noch hinter den unklaren datenschutzrechtlichen Rahmenbedingungen. "Sofern hier nicht bald Klarheit geschaffen wird, werden sich viele Unternehmen noch mit ihren Entwicklungen zurückhalten - und die Cloud-Lösungen können ihr volles Potenzial nicht ausschöpfen", bekräftigt der Webtrekk-Chef.
6. Risiken und Kosten des Data Management
Die Datenqualität hat bei mehr als einem Viertel der Unternehmen höchste Priorität, wenn es um den Betrieb eines CRM-Systems geht, so eine Studie der Züricher intelligent systems solutions (i2s) GmbH . Den Unternehmen entstehen "unnötige Kosten durch inadäquate Daten", sagt Holger Stelz , Leiter Geschäftsentwicklung bei der Uniserv GmbH Das Spektrum reicht etwa von Mailings, die einfach in den Weiten des Netzes verschwinden, wenn Mail-Adressen nicht stimmen, über fehlerhafte Rechnungen oder falsche Rechnungsadressen bis hin zu wichtigen Warensendungen, die den Empfänger nicht oder nicht rechtzeitig erreichen.Hinzu kommen Compliance-Anforderungen, die bei Nichtbeachtung oder fehlerhafter Umsetzung ein Unternehmen teuer zu stehen kommen. Eine Abmahnung wegen unerlaubter Telefonwerbung - weil Privatkunden versehentlich in eine Marketing-Datenbank aufgenommen werden - könne mehrere Tausend Euro kosten, weiß Stelz. Bei Verstößen gegen Sanktionslisten gehe der Schaden schnell in die Hunderttausende und sogar über die Millionengrenze.
"Ein weiterer Kostenfaktor", unterstreicht Sterz, sind "fehlerhafte und inkonsistente Daten, wenn sie die Ergebnisse analytischer Business-Applikationen verfälschen und so beispielsweise die Effizienz jeder Business-Intelligence-Lösung stark begrenzen." Nachbearbeitungen würden dann die Kosten weiter explodieren lassen, befürchtet Stelz.
Keine Angst vor großen Datenmengen
Wenn sich also, wie die Analysten von IDC voraussagen, das Datenvolumen zwischen jetzt und 2020 in den meisten Unternehmen um das 35-Fache aufblähen wird, so wird der Analysekomplex in ähnlicher Weise zunehmen - darin sind sich die Experten weitgehend einig. Es ist wie beim Gold, bei der Kohle und beim Eisenerz. Die Methoden zur Gewinnung der begehrten Rohstoffe haben sich auch stets verbessert. Selbst, wenn man sich durch immer mehr Erde wühlen und immer mehr Wasser filtern muss.Kommentar von Markus Howest
Chance statt Last
Riesige Datenmengen werden Unternehmen nicht ersticken, wenn sie es verstehen, sie für sich zu nutzen.
Weiterlesen



