Jetzt zum Webinar anmelden

November 2026 · Unser Geburtstagsgeschenk
35 Jahre iBusiness.
Im November alles frei lesen.
Zum Jubiläum öffnen wir alle iBusiness-Inhalte: vom 1. bis 30. November, für alle, ohne Anmeldung und ohne Bezahlschranke.
Alle Inhalte im November kostenlosRegistrieren Sie sich kostenlos und abonnieren Sie anschließend den iBusiness-Newsletter. So bleiben Sie bei den Themen auf dem Laufenden, die für Sie zählen.

Fünf Big-Data-Irrtümer, die im letzten Konferenzvortrag garantiert gefehlt haben
16.05.2014 Big Data automatisiert das Marketing, findet verborgene Zusammenhänge im Nutzer- und Kaufverhalten, erlaubt präzise Vorhersagen und macht Werbung besser, behaupten die Evangelisten. Alles Quatsch. Big Data kann viel weniger, als versprochen wird. Die fünf verbreitetsten Irrtümer und wie man mit Big Data tatsächlich in Zukunft umgehen kann.

HANDLUNGSRELEVANZ
|
|
Operativ |
Strategisch |
Visionär |
|
Technik |

|

|

|
|
Medien |
|
|
|
|
Wirtschaft |
|
|
|
|
|
heute |
morgen |
übermorgen |
Big Data - die Wundermaschine, vor der sich niemand verstecken kann. Die nur eine Nahrung braucht: Daten, Daten, Daten. Je mehr, desto besser. Doch wie bei jedem Hype werden auch bei diesem zu hohe Erwartungen geweckt. Zeit, mit den größten Irrtümern aufzuräumen:
Irrglaube 1: Mit Big Data werden Vorhersagen möglich
Am meisten überschätzt wird die Vorhersagegenauigkeit von Big Data. Getrieben wird sie von bekannten Beispielen, ohne die kaum ein Big-Data-Vortrag auskommt: Dank der jungen Technik soll die amerikanische Supermarktkette Target schon von der Schwangerschaft einer jungen Frau gewusst haben, bevor es der eigene Vater erfuhr. Ebenso populär ist das Beispiel von Googles Grippevorhersage , die anhand der Milliarden von Suchanfragen genau vorhersagen könne, wann und wo eine Grippewelle zu erwarten ist.| Beispiel 2: Google und die Grippe |
|---|
Das zweite gerne zitierte Beispiel für eine gelunge Big-Data-Anwendung lobt die Vorhersagegenauigkeit von Googles Grippe-Prognose Flutrends . Die Big-Data-Anwendung, die mit erstaunlicher Präzision Grippewellen vorhersagen kann, präsentierte der Suchgigant 2008 der Öffentlichkeit. Als Grundlage dienen die Anfragen zum Suchwort "Grippe". Es zeigte sich, das sich aus bestimmten Mustern (Ort, Häufigkeit und Art der Suchfragen) sehr genau ableiten ließ, wo demnächst eine Grippewelle auftreten wird. Die Google-Vorhersage konnte alle etablierten Prognosemodelle übertreffen und wurde genutzt, um Pharmaherstellern und -lieferanten bei der Planung zu helfen. |
| Beispiel 1: Target und die Schwangerschaft |
|---|
Ein Vater soll von der Schwangerschaft seiner jungen Tochter aus dem (gemeinsam empfangenen) Newsletter der US-Supermarktkette Target erfahren haben. Aufgrund des Einkaufsverhalten der Schülerin, die bestimmte Pflegeprodukte bestellt hatte, schloss die Big-Data-Maschine der Handelskette messerscharf, dass schon bald ein freudiges Ereignis bevorstünde und empfahl im Newsletter entsprechende Produkte. Der Legende nach beschwerte sich der Vater daraufhin bei der örtlichen Filiale des Supermarktes über die in seinen Augen unpassende Werbung - um kurz darauf zu erfahren, dass er bald Opa werden würde. |
Beide Beispiele sollen zeigen, mit welcher Präzision per Big Data Prognosen möglich sind, wenn nur genügend Daten ausgewertet werden. Die Beispiele suggerieren zudem, dass sich selbst Dinge, die wir nicht preisgeben wollen (Schwangerschaft) oder wissen können (Grippewelle) durch eine Verdichtung der Daten erkennen lassen. Tatsächlich gibt es jedoch sehr enge Grenzen für Vorhersagen. Komplizierte Vorgänge lassen sich vorhersagen. Komplexe Vorgänge nicht (s. Kasten).
In komplexen Systemen ist es lediglich möglich, Wahrscheinlichkeiten anzugeben. Je nach Komplexität des Systems werden diese sehr schnell ungenau - genau wie wir es vom Wetterbericht kennen.
| Komplizierte und komplexe Systeme |
|---|
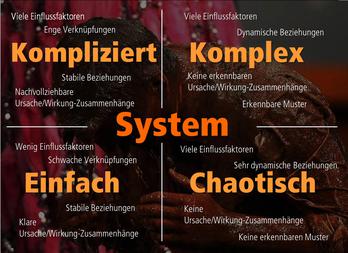
Bild: Joachim Graf
Die Unterschiede der Systemtheorie
|
In der Big-Data-Praxis heißt das: Die Vorhersagbarkeit komplexer Systeme verbessert sich durch Big Data nicht. Komplexe Systeme werden nicht besser begreifbar, nur weil mehr Daten zur Verfügung stehen. Bestenfalls werden komplizierte Zusammenhänge sichtbar, die bislang übersehen wurden.
Irrglaube 2: Big Data zeigt unbekannte Zusammenhänge
Wer in Big-Data-Maßstäben denkt, für den sind Tera- und Gigabyte keine Größe. Die wahren Datenschätze, so möchte man meinen, finden sich erst in Datenbanken mit ungeheurer Dimension. Dann werden plötzlich Zusammenhänge sichtbar, die bislang niemand für möglich gehalten hätte.Tatsächlich bietet Big Data die Möglichkeit, unstrukturierte Datenmengen von unvorstellbarer Größe mit sehr hoher Geschwindigkeit zu durchforsten. Und tatsächlich kann man in diesen Daten unerwartete Zusammenhänge finden. Allerdings ist es sehr kostenintensiv, scheinbar wahllos nach bislang unbekannten Zusammenhängen zu forschen, erklärt Klaas Wilhelm Bollhoefer , Chief Data Scientist der Berliner Big-Data-Firma "The unbelievable Machine Company" : "Einige Unternehmen mit großer Research-Abteilung oder einer großen Zahl an Doktoranden können sich das leisten".
In der Regel ist dieses Vorgehen aber teuer und ineffektiv. Schließlich lassen sich schon in vergleichsweise kleinen Datensammlungen beinahe beliebig viele Korrelationen entdecken. "Die Regenhäufigkeit in Brasilien und der Absatz des iPhones können eine wunderbare Korrelation bilden", erklärt der Experte. "Nur nützt dieses Wissen nichts, weil es keine Kausalität gibt." Entscheidend ist, dass der Marketer zum einen eine Kausalität herstellen kann und zum zweiten auf das Ereignis angemessen reagieren kann. Dazu muss er den Zusammenhang natürlich verstehen. Wenn mobile Besucher eines Shops schlecht konvertieren, kann der Marketer prüfen, ob diese vielleicht einfach in der Filiale vor Ort einkaufen. Stellt sich dieser Zusammenhang als richtig heraus, kann er darauf reagieren und beispielsweise in der mobilen Ansicht der Website die Produktverfügbarkeit im nächsten Laden prominent darstellen.
In der Big-Data-Praxis heißt das: Die Stärke von Big-Data-Software - große Mengen von unstrukturierten Daten schnell zu analysieren - lässt sich also wesentlich erfolgversprechender einsetzen, wenn beispielsweise Tweets gezielt auf ihren Inhalt untersucht werden, um festzustellen worüber die Nutzer sprechen. Big-Data-Software findet nicht einen Zusammenhang, sondern erlaubt es, eine gedachte Kausalität zu prüfen.
Irrglaube 3: Je mehr Daten, desto besser
Sowohl das Beispiel der Supermarktkette Target als auch das Google-Beispiel zeigen deutlich, dass es letztlich nur sehr wenige Daten sind, die für die verblüffend genaue Vorhersage nötig sind. Nicht eine Unmenge von Daten haben zu der Erkenntnis geführt, dass die Kundin vermutlich schwanger ist, sondern nur einige wenige. Letztlich handelte es sich in dem vielzitierten Beispiel lediglich um eine Recommendation-Engine, die das Einkaufsverhalten auswertete. Auch bei Google liegt die Kunst vor allem darin, aus der Vielzahl von Suchanfragen die relevanten herauszufiltern.In der Big-Data-Praxis bedeutet das: Entscheidend ist, dass der Marketer die Regel kennt. Dann muss er noch die (wenigen) für die Regel relevanten Daten aus dem Wust filtern. Big-Data-Software wird aber nicht automatisch bessere Antworten liefern, weil größere Datenmengen zur Verfügung stehen. Wer weiß, wonach er sucht, kann mit Big Data aber mehr Datenquellen durchforsten und hat deswegen die Chance, fündig zu werden.
Irrglaube 4: Big Data liefert Erklärungen
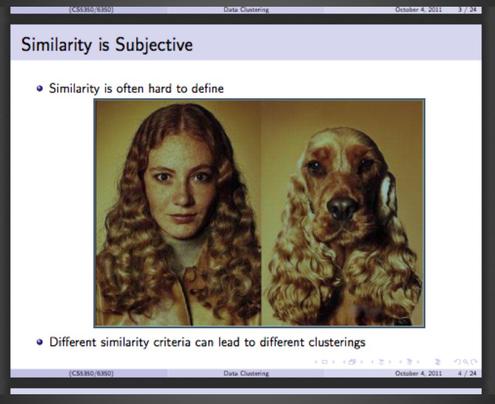
Big-Data-Software wird gerne mit künstlicher Intelligenz, lernenden Maschinen und Prinzipien der Computerlinguistik ergänzt. So können die Computer heute den Inhalt und (in Grenzen) sogar die Intention eines Tweets erfassen, Bilder analysieren oder versuchen, Kausalitäten zu erkennen. Letzteres können sie jedoch nicht besonders gut. "Maschinen tun sich sehr schwer damit, Ergebnisse zu interpretieren", sagt Bollhoefer.
Maschinen sind in vielen Dingen unbestechlich genau, bei denen Menschen leicht Fehler machen. Umgekehrt interpretieren Maschinen Daten aber oft unglaublich schlecht, die für Menschen völlig problemlos auseinanderzuhalten sind (s. Bild). Diese Schwäche hält bis heute an. "Vor einigen Jahren waren Menschen den Schachcomputern noch überlegen. Inzwischen sind Hochleistungscomputer 'intelligent' genug, um einen Weltmeister zu besiegen. Ungeschlagen ist aber immer noch die Kombination: Schachcomputer schlägt vor, Mensch entscheidet," erklärt Bollhoefer. Weder Schachcomputer noch Mensch müssen dann Spitzenklasse sein, um den Hochleistungscomputer zu besiegen. Wirklich gut ist die maschinelle Rechenleistung nur in Kombination mit menschlicher Interpretationsstärke.

In der Praxis bedeutet das: Big-Data-Technologie ist ein starkes Hilfsmittel, wenn man weiß, was man will. Big Data kann sagen, wie viele Menschen die Farbe Schwarz mögen (oder das zumindest behaupten). Aber nicht warum. Big Data gibt Antworten. Aber keine Erklärung.
Irrglaube 5: Durch Big Data funktioniert Werbung besser
Zugegeben, eigentlich handelt es sich nur um einen halben Irrglauben. Denn natürlich ist es richtig, dass mittels Big Data aus den richtigen Informationen in Sekundenbruchteilen die richtigen Schlüsse gezogen werden können. Ob jemand ein Mann oder eine Frau ist, einen Hund besitzt, sich für Autos interessiert, offenbar an Grippe erkrankt oder eben schwanger ist, kann das Surf- oder Einkaufsverhalten verraten. Ein Trugschluss ist es aber trotzdem, dass Werbung deswegen automatisch besser wird. Zumindest nicht heute. Denn meist gipfeln die gesamten, mühsam gewonnenen Erkenntnisse in einem inzwischen wohlbekannten Bannermotiv: "Schuh, 149 Euro".
Jost Köllner , Geschäftsführer der Agentur Zum Goldenen Hirschen Köln hält solche Kampagnen inzwischen typisch für maschinengetriebenes Marketing. Nur: Sie transportieren Emotionen ungefähr so fassettenreich wie ein Halbleiter Schaltzustände. Auf der Strecke bleibt der Aufbau von Marken- und Sympathiewerten, eine witzige, humorvolle und aufmerksamkeitsstarke Ansprache, die Verführung zum Kauf.
"Menschen sind keine ausrechenbaren Konsumeinheiten. Big Data sollte genutzt werden, um besser zuzuhören", meint Köllner. "Wo liegen die Kaufbarrieren und -treiber? Wofür interessieren sich die Käufer?" All diese Informationen sind in Tweets, Blogs und Postings enthalten und lassen sich maschinell auswerten. So kann ein Marketer Themen identifizieren und in seiner Kommunikation darauf reagieren. Mit den klassischen Mitteln kreativer Werbung, die das Belohnungssystem anspricht, Begehrlichkeit weckt, Markenpräferenz schafft und eine Story transportiert.
In der Praxis bedeutet das: Damit Big Data beim Marketing hilft, muss nicht immer nur entlang des Produkts gedacht werden. Notwendig ist dazu eine Marke, die eine starke und klare Identität hat. Denn nur dann lässt sich die Kernbotschaft auf vielfältige Weise transportieren und in Kampagnen rasch umsetzen.
Kommentar von Dominik Grollmann
Möchten Sie "wahrscheinlich zufriedene" Kunden?
Jedes mittlere Unternehmen ist heute in der Lage, petabyteweise Daten zu sammeln. Und es werden immer mehr: Fitbit-Schrittzähler, Nest-Thermostate, Smartphones und jede damit durchgeführte Interaktion erzeugen neue Datenspuren. Nur: Die Herausforderung von Big Data liegt nicht darin, möglichst viele Daten zu sammeln.
Weiterlesen

Am: 16.05.2014
Zu: Fünf Big-Data-Irrtümer, die im letzten Konferenzvortrag garantiert gefehlt haben
BigData liefert da sehr wohl statistisch bessere Wahrscheinlichkeiten, natürlich nur, wenn die entsprechenden Frage gestellt wird. Ohne Frage keine Anwort. Wie sollte BigData auch Antworten ohne dazu die passende Frage zu haben.
Herrn Köllner muss ich leider auch widersprechen. DIE Menschen sind ausrechenbare Konsumeinheiten, nur eben nicht jeder einzelne für sich. Dies würde auch keinen Sinn machen, da die Werbung viel zu teuer wäre, würde diese ganz individuell auf jeden Menschen zugeschnitten (wenngleich dieses angestrebt wird). Es geht hier einfach um den gemeinsamen Nenner, die Massen, die den höchsten Umsatz bei den geringsten Kosten erzielt. Selbstverständlich müssen für den Absatz der Produkte auch alle anderen Rahmenbedingen möglichst optimal erfüllt sein. BigData ist nur ein zusätzliches Werkzeug.
Am: 16.05.2014
Zu: Fünf Big-Data-Irrtümer, die im letzten Konferenzvortrag garantiert gefehlt haben
BigData liefert da sehr wohl statistisch bessere Wahrscheinlichkeiten, natürlich nur, wenn die entsprechenden Frage gestellt wird. Ohne Frage keine Anwort. Wie sollte BigData auch antworten, ohne dazu die passende Frage zu haben.
Herrn Köllner muss ich leider auch widersprechen. DIE Menschen sind ausrechenbare Konsumeinheiten, nur eben nicht jeder einzelne für sich. Dies würde auch keinen Sinn machen, da die Werbung viel zu teuer wäre, würde diese ganz individuell auf jeden Menschen zugeschnitten (wenngleich dieses angestrebt wird). Es geht hier einfach um den gemeinsamen Nenner, die Massen, die den höchsten Umsatz bei den geringsten Kosten erzielt. Selbstverständlich müssen für den Absatz der Produkte auch alle anderen Rahmenbedingen möglichst optimal erfüllt sein. BigData ist nur ein zusätzliches Werkzeug.