Jetzt zum Webinar anmelden

Agenturwert berechnen
November 2026 · Unser Geburtstagsgeschenk
35 Jahre iBusiness.
Im November alles frei lesen.
Zum Jubiläum öffnen wir alle iBusiness-Inhalte: vom 1. bis 30. November, für alle, ohne Anmeldung und ohne Bezahlschranke.
Alle Inhalte im November kostenlosRegistrieren Sie sich kostenlos und abonnieren Sie anschließend den iBusiness-Newsletter. So bleiben Sie bei den Themen auf dem Laufenden, die für Sie zählen.

Semantische Suche: Die ewige Herkulesaufgabe
13.11.2012 So unspektakulär es klingen mag: Die Auffindbarkeit relevanter Informationen ist einer der wichtigsten Schlüsselfaktoren der Zukunft - im Web und in Unternehmen. Auch wenn der Weg zur semantischen Suche, die diesen Namen auch verdient, noch weit ist: Einige Ansätze gibt es schon, die die Zukunft der Suche zeigen.

Wenn man einmal mit der Idee des semantischen Web begonnen hat, wird so viel möglich, skizzierte er die semantische Zukunft vor rund acht Jahren in einem Interview . Dabei nahm er das Problem semantischer Suchtechnologien nahezu orakelartig vorweg: Es werde noch viele Jahrzehnte dauern, bis die Idee ganz umgesetzt sei - "wenn wir es denn je schaffen".
Soweit ist es noch lange nicht. Der Status quo im Endnutzermarkt semantischer Suche orientiert sich im Wesentlichen an vier Lösungen:
- Da ist zunächst Wolfram Alpha , auch die "rechnende Wissensmaschine" genannt, was schon zeigt, wie eingeschränkt der Nutzerkreis ist, der hauptsächlich aus Mathematikern besteht. "Für die Allgemeinheit ist Wolfram Alpha nicht einsetzbar, weil es von der Usability und dem Frontend her zu komplex ist und für Otto-Normal-Nutzer somit kaum zugänglich", winkt Alexander Siebert , Geschäftsführer des Suchlösungsspezialisten Retresco , darum auch ab. Gestartet als Universalsuchmaschine gibt Wolfram Alpha heute vor allem die Antworten korrekt aus, die leicht zu analysieren sind - und das sind offensichlich vor allem diejenigen aus der (leicht zu strukturierenden) Mathematik.
- Mehr Breitenwirkung erzielte Siri - zumindest bei Markteintritt. Apples semantisches Spracherkennungstool wird aber erst dann seine angepeilte Funktion als persönlicher mobiler Assistent erfüllen können, wenn "noch viel mehr Intelligenz dazukommt", ist Siebert überzeugt und räumt ein: "Siri ist sicher ein Indikator, wo die Entwicklung hingeht. Als Anwendung ist Siri noch nicht ausgereift, schafft aber schon jetzt ein ganz neues Nutzer-Interface."
- IBM Watson vereinigt sowohl Aspekte von Wolfram Alpha als auch von Siri in sich. Der semantisch arbeitende Quizcomputer, der mit seinem Sieg in der US-Quizshow Jeopardy für Aufsehen sorgte, ist ein prototypisches Beispiel: Er arbeitet sowohl mit semantischen Annotationen als auch Faktenwissen und sucht sich die passenden Antworten heraus. Der US-Krankenversicherer WellPoint setzt Watson seit 2012 ein, um Ärzte bei der Diagnose zu unterstützen und Behandlungsmethoden zu suchen (Video ).
"Dafür sind sehr viel Hardware und Millioneninvestments nötig", weiß Siebert. Entsprechend eingeschränkt ist bislang noch der Anwendungsbereich. Das wiederum macht Siri spannend, weil es zeigt, was auf einem kleinen Endgerät möglich ist - "nicht mit der Komplexität von Watson. Aber die Hardware wird ja immer besser", sagt Siebert.
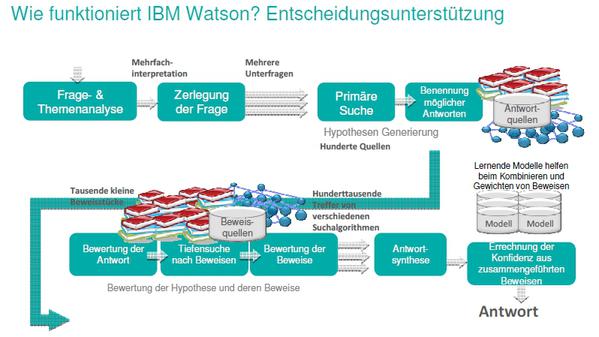 Bild: IBMIBM Watson versteht die menschliche Sprache, lernt durch Interaktion, analysiert die Daten und soll so bessere Ergebnisse liefern.
- Google schließlich will mit seinem Knowledge Graph - vorerst nur im englischsprachigen Web - Nutzereingaben und gefundene Informationen besser "verstehen", statt nur nach übereinstimmenden Wörtern zu suchen .
Denn die Suche von Unternehmen ist wesentlich komplexer als die von Endnutzern. "Wolfram Alpha fragt man, wie hoch der Mount Everest ist. Das will der Mitarbeiter bei Bayer oder Bosch nicht wissen", winkt Gölitz ab. Das Grundproblem im Bereich Enterprise-Search ist: Unternehmen besitzen Millionen von Dokumenten, die komplett unstrukturiert sind. Experten schätzen, dass der Anteil unstrukturierter Informationen im Unternehmen bei 85 Prozent liegt. Während strukturierte Informationen Daten zum Wer, Was, Wieviel und Wann enthalten, behandeln unstrukturierte Informationen Fragen zum Warum und Wie.
"Viele kleine Pflaster, aber noch kein Allheilmittel"
Gefragt sind intelligente Suchmaschinen, die Clustering bilden und helfen, überhaupt erst einmal den Ansatzpunkt für eine effektive Suche zu finden. Auch Boolesche Operatoren - also die bekannten Suchbegriff-Verknüpfungen mit UND oder NICHT helfen nicht weiter. Denn in diesem Fall muss man schon sehr genau wissen, wonach man sucht. "Im Prinzip läuft es noch immer darauf hinaus, dass 20 Anwälte hunderte Ordner per Hand nach relevanten Dokumenten durchforsten", hat Gölitz erfahren. "Im stark spezialisierten Businessbereich gibt es bislang viele einzelne Lösungen, die man als Pflaster auf einzelne Stellen klebt. Ein Allheilmittel gibt es noch nicht", winkt er ab.Topiczoom selber geht deshalb mit seiner Suchlösung den Weg über Ontologien - im Unterschied zu Thesauri und Taxonomien (Klassifikationsschemata). Die Ontologie verknüpft allgemeine Wissensgebiete, bspw. würde eine Verknüpfungskette zum Thema Essen/Trinken über Getränke (alkoholisch/nicht-alkoholisch) laufen; bei Alkoholisch über Weine, dann über Rotweine etc., bis hin zum Winzer, der auch eine Verknüpfung in die Wirtschaft hat, weil er ein Unternehmen und damit Wirtschaftsrelevanz hat.
"Es bedarf einer enorm hohen Rechen- und Speicherkapazität, um komplexe Beziehungen, die nicht 1:1, sondern 1:n betragen, zu berechnen", erklärt der Semantik-Experte. Hier stoßen Technologie und Unternehmen schnell an ihre Grenzen. Topiczoom berechnet knapp 100.000 Themen mit 500.000 Begriffen und Millionen Beziehungen. Dieses Problem haben die Münchner mit intelligenten Algorithmen gelöst. Für Unternehmen aber bedeutet das: Ohne Millioneninvestitionen in IT, Konzeptberatung und -umsetzung geht da nichts.
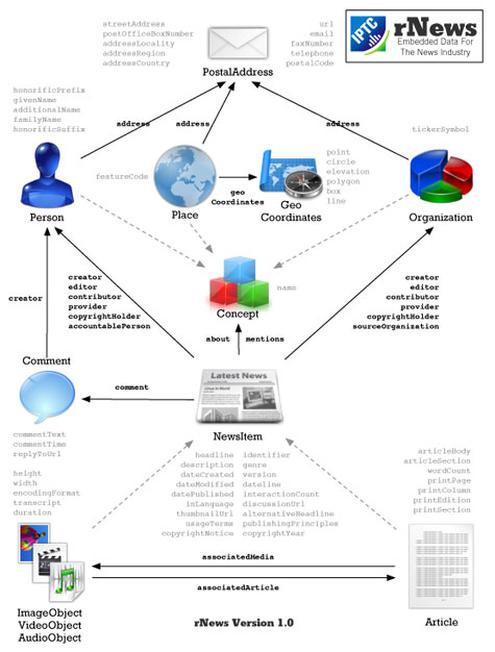
Auch Verlage versuchen, mittels Semantik ihre Inhaltemengen verlagsübergreifend für Redakteure und Leser zu erschließen. Die New York Times beispielsweise hat als erste große Tageszeitung schon 2011 damit begonnen, ihre Inhalte mit dem Standard "rNews" zu veröffentlichen, um aktuellen Content auf Webseiten so mit Metadaten anzureichern, dass der News-Content fürs semantische Web aufbereitet werden kann . Und wenn Sie bei iBusiness in die Tagcloud klicken, auf einen Firmennamen oder eine Person, dann landen Sie in unserem Relation-Browser, der Stichwörter, Personen und Unternehmen miteinander verknüpft und so semantische Verbindungen herstellt.
Automatisierte Aussteuerung von Verticals
Bei der New York Times kann der Redakteur aus semantisch angereicherten Inhaltepools schöpfen, um Content mehrfach zu verwerten, beispielsweise über die Ausspielung von Verticals. Automatisierung hilft bei der Befüllung themenspezifischer Portale, bspw. zu Gesundheit, Auto, Sport, Specials etc., und Sonderpublikationen, wo der Kostendruck auch hoch ist. Indem er Themen eingibt und diese dann automatisiert einfließen, kann der Redakteur auch drei oder vier Verticals gleichzeitig steuern.Kleinere US-Anbieter wie Statsheet praktizieren dieses Prinzip schon für Sportnachrichten . Auf Basis von Tweets und Faktenwissen generieren sie automatisch Sportberichte, was den angenehmen Nebeneffekt der Kostenreduktion hat. Der Redakteur ist dabei überflüssig. Er braucht nicht mehr Artikel per Hand hin- und herzuschieben und kann sich mehr um seine eigentliche Arbeit kümmern: dem Schreiben der Artikel. Die Leser hätten dabei nicht bemerkt, dass die Sportnachrichten maschinell produziert wurden, erzählt Alexander Siebert.
Bei Fachverlagen liegt der Fall ein wenig anders. Die meisten Inhalte liegen oft nicht einmal in digitaler Form vor. Der wissenschaftliche Fachverlag De Gruyter ist da schon relativ weit. 2008 hatte er beschlossen, dass alle Inhalte sowohl digital als auch gedruckt vorliegen sollen. 35 Prozent ihres Jahresumsatzes von 45 Millionen Euro machen die Berliner mit elektronischen Produkten, vor fünf Jahren waren es noch zwischen fünf und zehn Prozent. "Es gibt natürlich auch Kannibalisierungseffekte mit Printprodukten. Aber wir wollten für die Lektorate die Option schaffen, Inhalte zu akquirieren - unabhängig davon, in welchem Format sie verkauft werden", erklärt Verlagsgeschäftsführer Dr. Sven Fund . Deshalb hat De Gruyter in diesen Tagen "Customized Publishing" gestartet. Nach dem Prinzip "Build your own book" soll der Kunde sich aus beliebigen Inhalten und Formaten (Büchern, Zeitschriften, Datenbankeinträgen) sein eigenes Werk zusammenstellen können, das er als Print-on-Demand erhält.
"Dramatische Veränderung" für Fachverlage
Die Digitalisierung für Wissenschaftsverlage ist eine "brutale Herausforderung", schildert Fund: "Wir haben wahnsinnige Mengen an Inhalten, die sehr spitze Zielgruppen bedienen." Das bedeutet: Sowohl bei der Auffindbarkeit/Suche als auch in Form des anschließenden Kaufs müsse man dafür sorgen, dass das Paket so geschnürt ist, wie der Kunde es will. Das sei eine "dramatische Veränderung", denn Wissenschaftsverlage sind traditionell extrem autorengetrieben: Hat man einmal mit Prof. Müller-Lüdenscheidt ein erfolgreiches Buch publiziert, wird man das mit hoher Wahrscheinlichkeit weiterhin tun. Der Zeitschriftenmarkt tickt da ganz anders.Das Matching ist dabei zentral: Per Semantik sollen Texte klassifiziert, Ähnlichkeiten berechnet und so zusätzliche Interaktionsoptionen für den Nutzer geschaffen werden. "Also beispielsweise: Auf Basis der vier ausgewählten Dokumente haben wir in unseren 15 Millionen Datenbankeinträgen noch folgende zehn gefunden, die inhaltlich gut passen würden", erläutert Fund. In Zukunft wollen die Berliner noch externe Datensätze einbinden und damit technisch die Option schaffen, eigene Datenquellen mit anderen vernetzen zu können. Auch die Forschungsdaten des Autors, bislang noch stiefmütterlich behandelt, sollen künftig technisch und semantisch integriert werden.
Doch bislang gibt es kaum deutschsprachige Lösungen, die die Kundenanforderungen an semantische Suche erfüllen können. Der Grund: Die deutsche Sprache mit ihren Komposita, Spezialausdrücken und Bildern ist wesentlich komplizierter als das Englische. Deshalb funktioniert Speech-to-text bei Siri fürs Deutsche auch noch nicht zufriedenstellend. Hinzu kommt: Der Markt speziell für Lösungen in der Industrie ist noch stark fragmentiert. Wo das entsprechende Budget da ist, bauen Unternehmen für ihr spezielles Faktenwissen semantische Datenbanken ("Triple Stores") auf. Die Maschinen mit den relevanten Daten zu füttern, ist momentan noch die Krux. Denn die Suchalgorithmen arbeiten nur so gut, wie die Inhalte schon aufbereitet sind. Das ist bislang nur bei rund zwei Prozent der Online-Inhalte der Fall.
Semantische Auszeichnung krempelt SEO um
Inhalte im Web so auszuzeichnen, dass sie für Maschinen vernünftig verwertbar sind, ist die große Aufgabe. Große Publisher experimentieren damit, Google bringt das Thema mit Schema.org (gemeinsam mit Yahoo und Bing ) und durch Rich-Snippet-Auszeichnungen voran. So kann ich als Autor eines Blogs ein Profilfoto miteinstellen. Google verbindet die Daten miteinander, sodass man in den Google-Ergebnislisten sein Foto und Autorenprofil sieht. Das Suchergebnis in Google wird dadurch prominenter für den Leser und sieht relevanter aus. "Google wird das irgendwann in seine SEO-Algorithmen einbinden, dass die vorliegenden Daten semantisch ausgezeichnet sind", ist Alexander Siebert überzeugt.
Kommentar von Joachim Graf
Semantik ist die Basis für Agenten-Software
Semantische Analyse ist die Basis für das wahre Zukunftsfeld der interaktiven Medien: Die Agenten-Software.
Weiterlesen